Hay un momento especialmente frustrante en desarrollo: todo funciona en local y, después del despliegue, una función concreta deja de responder. La reacción habitual es buscar un culpable rápido. La realidad suele ser más aburrida: producción es otro entorno.
Localhost no es producción
En local solemos tener otras variables, menos caché, rutas distintas, certificados diferentes, datos de prueba y servicios ejecutándose con permisos o configuraciones que no existen en el dominio real.
La primera regla es no comparar solo la pantalla. Compara las condiciones que producen esa pantalla.
Reproduce con la URL real
Abre el dominio final, preferiblemente en una ventana privada, y ejecuta exactamente la misma acción. Si cambia el comportamiento al eliminar cookies, revisa sesiones y caché. Si persiste, abre DevTools.
Console y Network
Console indica qué está diciendo el navegador. Network permite observar cada petición: URL, método, código HTTP, cabeceras, tiempos y respuesta. Un 401, un 403 y un 404 son problemas diferentes aunque todos terminen siendo un “no funciona”.
CSP, CORS y recursos externos
Una integración puede funcionar en local y ser bloqueada en producción por una política de seguridad, un origen distinto o una configuración del proveedor. Vídeo, analytics, CAPTCHA, fuentes, imágenes e iframes son candidatos frecuentes.
Dominios y cookies
https://www.fmcplabs.com y https://fmcplabs.com tienen orígenes diferentes. Un servicio externo puede aceptar uno y rechazar otro. Las cookies también dependen de dominio, Secure, SameSite y ruta.
Variables de entorno
Una variable que existe en desarrollo puede faltar en producción, contener un valor antiguo o apuntar al proveedor equivocado. Revisa qué valores necesita realmente la aplicación sin imprimir secretos en logs.
Caché y CDN
Una corrección puede estar desplegada y seguir sin verse porque existe una capa de caché. Hay que distinguir entre código nuevo, datos nuevos y respuesta cacheada antes de seguir cambiando el proyecto.
Cuatro capas de diagnóstico
Navegador: consola, Network, cookies y recursos bloqueados.
Aplicación: rutas, configuración, renderizado, errores y datos.
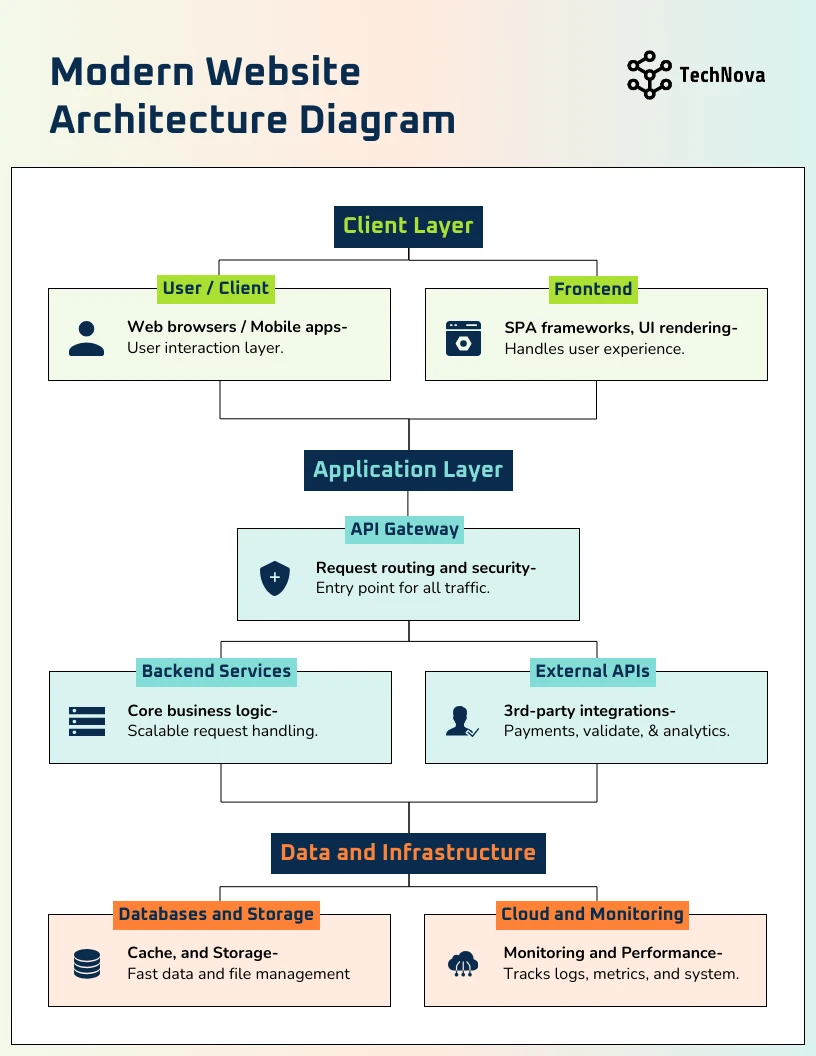
Infraestructura: DNS, CDN, Vercel, caché y variables.
Servicios externos: Supabase, vídeo, pagos, APIs, CAPTCHA y analítica.
Compara, no adivines
Coloca local y producción uno al lado del otro y anota diferencias concretas. Misma URL, mismo usuario, misma petición y mismo recurso. Cambiar diez cosas a la vez destruye la información del experimento.
Captura antes de modificar
Guarda la evidencia del fallo antes de tocar código: hora, URL, código HTTP, mensaje de consola y petición afectada. Cuando desaparece después de un cambio, esa evidencia permite saber qué se arregló realmente.
El laboratorio de producción
Una producción madura no es la que nunca falla. Es la que convierte los fallos en casos reproducibles. La corrección buena explica la causa y añade una comprobación para evitar la regresión.
Cierre FMCP
Cuando una web falla solo en producción, el entorno forma parte del problema. DNS, CDN, cookies, variables, seguridad, permisos y proveedores son parte de la aplicación final.
Checklist
- Reproducir en el dominio real.
- Revisar Console y Network.
- Comparar variables sin exponer secretos.
- Revisar CSP y CORS.
- Comprobar cookies y dominios.
- Revisar caché y CDN.
- Comparar servicios externos.
- Documentar el diagnóstico y repetir la prueba.
Una investigación de producción necesita observaciones reproducibles
Cuando una aplicación funciona en local y falla después del despliegue, el primer objetivo es convertir una sensación en un caso reproducible. Escribe la URL, la acción exacta, el resultado esperado y el resultado real. Añade navegador, dispositivo, hora y cualquier código HTTP visible. Con eso ya puedes empezar a comparar.
La primera comparación: mismo flujo, distinto entorno
No cambies de usuario, de URL y de navegador al mismo tiempo. Repite el mismo flujo en localhost, preview y producción. Si falla únicamente en uno de los tres, has reducido el problema a una diferencia de entorno.
El navegador como fuente de evidencia
Console muestra errores de JavaScript, políticas y recursos bloqueados. Network muestra las peticiones reales. Una pantalla que simplemente dice “no funciona” es una señal muy pobre; una respuesta 401, 403, 404 o 500 es una pista mucho más útil.
Autenticación, cookies y origen
Los problemas de sesión son especialmente engañosos. Una interfaz puede mostrarse correctamente y, sin embargo, una cookie no llegar al servidor. Comprueba el dominio, Secure, SameSite, HTTPS y el origen exacto de la petición. También revisa si la aplicación está utilizando www o el dominio raíz.
Una 401 y una 403 cuentan historias diferentes
Una respuesta 401 normalmente apunta a identidad o ausencia de credenciales. Una 403 indica que la identidad puede existir, pero la operación está siendo rechazada. No conviene solucionar una de ellas aplicando una excepción pensada para la otra.
CSP, CORS y proveedores externos
Un recurso puede existir y, aun así, no llegar al usuario. CSP puede impedir un iframe, una imagen, una fuente o un script. CORS puede bloquear una petición desde el navegador. Un proveedor puede comprobar el origen antes de aceptar la integración. La solución correcta depende de cuál de estas capas esté interviniendo.
No abras toda la política para probar
Cambiar * en varias directivas puede hacer que una prueba pase, pero destruye el valor de la protección y no identifica la causa real. Es mejor comprobar qué dominio se está solicitando, qué directiva lo afecta y qué respuesta devuelve el navegador.
Variables de entorno y configuración
Uno de los fallos clásicos es asumir que porque una variable existe en .env.local también existe en producción. Una API pública, un endpoint, un bucket o una bandera de funcionalidad puede apuntar a un lugar distinto. Comprueba comportamiento efectivo sin imprimir secretos.
La configuración también es código
Las diferencias entre entornos deberían ser explícitas. Cuando una configuración solo existe en el panel de Vercel o Cloudflare y no queda documentada en el proyecto, la próxima incidencia será más difícil de reproducir.
Caché y CDN
Una aplicación puede haber cambiado correctamente y seguir mostrando una respuesta antigua. Distingue entre el código desplegado, la respuesta del servidor, una caché del CDN y la caché del navegador. Haz una prueba privada y, cuando sea posible, comprueba también la respuesta con una segunda herramienta.
Una matriz de diagnóstico útil
| Capa | Qué comprobar |
|---|---|
| Navegador | Console, Network, cookies, CSP |
| Aplicación | rutas, datos, errores de hidratación |
| Infraestructura | DNS, CDN, cache, headers |
| Servicios | Supabase, vídeo, pagos, captcha, APIs |
| Datos | permisos, IDs, registros esperados |
Esta tabla es deliberadamente sencilla. Su valor está en obligarte a comparar observaciones y no intuiciones.
Después del arreglo
Repite el caso original y añade un caso negativo. Si el problema estaba relacionado con permisos, prueba un recurso que debería rechazarse. Si era una URL, prueba una URL incorrecta. Si era caché, comprueba el comportamiento después de una recarga limpia.
Convierte el incidente en una mejora
La investigación no debería terminar con “ya funciona”. Guarda la causa, la solución y una comprobación que pueda repetirse en el próximo despliegue. Así un problema de producción se transforma en una prueba futura.
Cierre FMCP
La producción no es magia ni una versión misteriosa de localhost. Es otro conjunto de condiciones. Cuando una función falla, compara las condiciones que cambiaron y no las reemplaces todas a la vez. Esa disciplina es una de las formas más rápidas de encontrar la causa real.
Qué cambia cuando una web falla solo en producción
El síntoma más engañoso de un incidente de producción es que el código parece correcto porque en local funciona. En realidad, producción añade variables que no aparecen en el portátil: DNS, certificados, CDN, proxies, cabeceras, secretos, permisos, regiones, cachés, límites de memoria y diferencias de versión. El objetivo de una investigación profesional no es encontrar rápidamente un culpable, sino reducir el espacio de posibilidades sin destruir las pruebas.
1. Separar síntoma, causa y punto de fallo
Una petición que termina en 500 no significa necesariamente que el fallo esté en la aplicación. Puede existir un 502 generado por un proxy, un 504 por timeout, un error TLS antes de llegar al servidor o un fallo de resolución DNS que ni siquiera alcanza el runtime. Antes de editar código conviene construir una cadena mínima: navegador → DNS → CDN o proxy → plataforma → proceso → servicio externo → base de datos.
Ese mapa permite preguntar algo mucho más útil: ¿hasta qué punto de la cadena llegó la petición? Si no existe log de entrada en la aplicación, no tiene sentido empezar revisando una función de React. Si el proceso registra la petición pero falla al consultar una API externa, el problema cambia de capa.
2. Comparar entornos con variables reales
La comparación correcta no consiste en mirar si dos repositorios tienen el mismo commit. Hay que comparar configuración. Las variables de entorno son especialmente importantes porque una clave, un host o una bandera de ejecución distinta puede cambiar completamente el comportamiento.
Un procedimiento seguro es crear una tabla con nombre de variable, presencia en local y producción, pero nunca copiar secretos dentro de documentos o tickets. Después se comparan también versiones de Node, runtime, dependencias, región de despliegue y configuración de build. Muchas incidencias aparentemente aleatorias desaparecen cuando se descubre que local usa una versión distinta del runtime o que producción apunta a otro endpoint.
3. Observar antes de modificar
Durante los primeros minutos de una incidencia, cada cambio puede borrar información útil. Reiniciar servicios, cambiar configuración y volver a desplegar puede ocultar el estado exacto que causó el problema. Es preferible capturar primero hora, endpoint afectado, código HTTP, request ID, logs, métricas y cambios recientes.
Una práctica sencilla es abrir una línea temporal: último despliegue, primera alerta, primera petición fallida, cambio de DNS, error de tercero y recuperación. Después se contrasta con usuarios reales. Si el problema aparece solo en una región o solo detrás de una CDN, esa pista vale mucho más que diez conjeturas sobre el código.
4. El patrón de depuración por capas
Empieza por disponibilidad. Después comprueba DNS y TLS. Continúa con el proxy o CDN. Luego revisa el runtime y, finalmente, dependencias externas. En cada capa pregunta tres cosas: qué esperaba recibir, qué recibió realmente y dónde queda registrado el resultado.
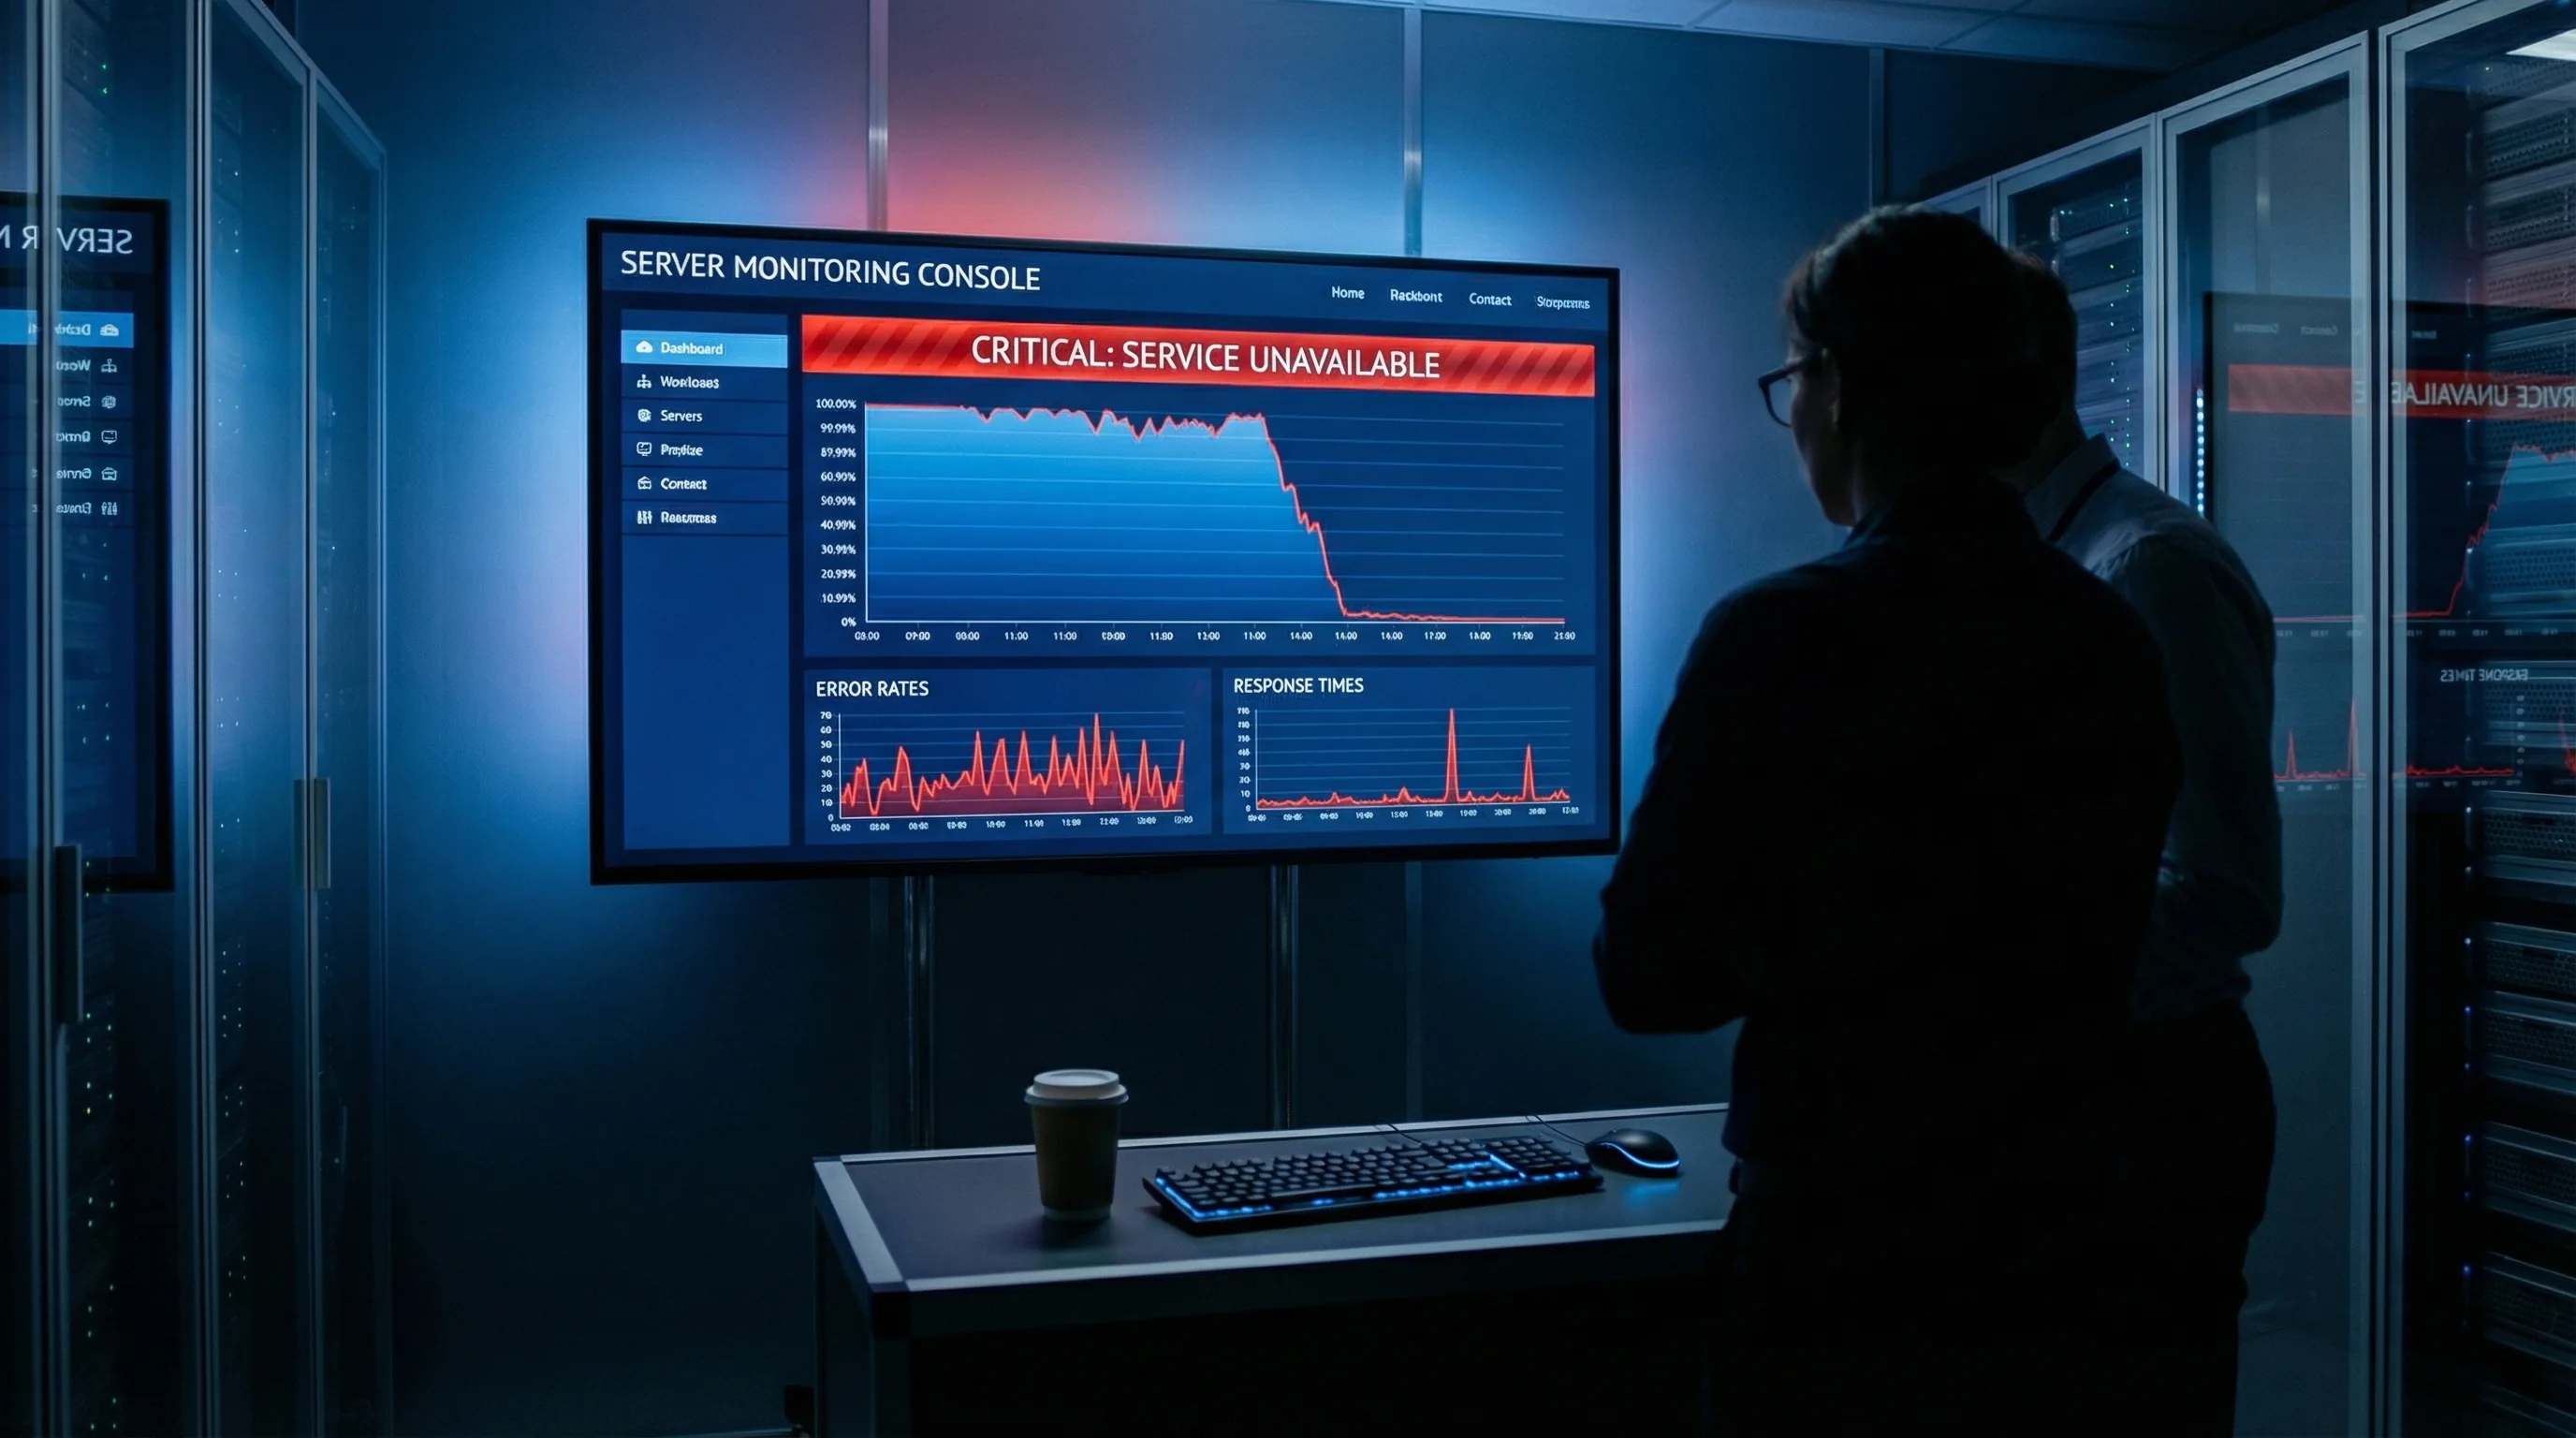
Un ejemplo: la interfaz muestra una pantalla en blanco. La pestaña Network revela un 200 para HTML, pero un JavaScript devuelve 500. El servidor sí está respondiendo. Si el bundle carga y la API devuelve datos, quizá el fallo sea de hidratación del cliente. Sin esas capas, “la web está caída” es una descripción demasiado pobre para actuar.
5. Qué debería quedar después del incidente
Un buen postmortem no termina con “se arregló”. Debe dejar una causa técnica, un factor contribuyente, el indicador que permitió detectar el fallo, la acción correctiva y la medida preventiva. También debe indicar qué señal habría permitido detectar el incidente antes.
La mayor mejora que puede recibir un proyecto no es una colección de trucos para arreglar errores concretos, sino una arquitectura que haga visibles los límites entre componentes. Cuando cada capa tiene logs útiles, identificadores correlacionables, health checks y métricas mínimas, el siguiente incidente deja de ser un misterio y se convierte en una investigación reproducible.
Checklist operativo
- Confirmar código HTTP y capa que lo genera.
- Comprobar DNS, TLS, CDN y origen por separado.
- Comparar configuración sin exponer secretos.
- Identificar el último cambio antes del incidente.
- Capturar logs y métricas antes de reiniciar o redeplegar.
- Correlacionar una petición con un request ID.
- Verificar dependencias externas y sus límites.
- Documentar causa, detección, mitigación y prevención.
La lección final es simple: cuando una web falla solo en producción, el problema suele estar en la diferencia entre sistemas, no necesariamente en una línea de código.