Durante los últimos años hemos aprendido a convivir con asistentes de programación que completan líneas, explican funciones, sugieren tests y escriben pequeños bloques de código. El siguiente salto no consiste simplemente en que esos asistentes escriban código más rápido. Consiste en que empiecen a trabajar con un objetivo completo: entender un repositorio, proponer un plan, editar varios archivos, ejecutar comprobaciones, interpretar errores y continuar hasta acercarse a un resultado verificable.
Ese cambio parece pequeño cuando se explica en una frase y enorme cuando se vive dentro de un proyecto real. Un copiloto acelera una decisión humana. Un agente intenta hacerse cargo de una secuencia de decisiones y acciones. En 2026, esa diferencia se ha convertido en uno de los cambios más interesantes de la ingeniería de software.
Este artículo es una guía extensa para entender qué está ocurriendo, por qué importa, qué puede hacer hoy un agente de programación, dónde sigue fallando y cómo debería adaptarse un equipo que quiera utilizarlo sin convertir su repositorio en una caja negra.
El cambio importante no es escribir código
Cuando hablamos de IA aplicada al desarrollo es fácil centrarse en la parte más visible: generar código. Sin embargo, escribir código es solo una fracción del trabajo real de un desarrollador.
Antes de crear una función hay que localizar dónde encaja. Hay que comprender las convenciones del proyecto, leer tipos existentes, identificar dependencias, entender la base de datos, averiguar cómo se autentica la aplicación, comprobar qué tests existen y decidir qué comportamiento no debe romperse. Después de escribir el código hay que ejecutarlo, observar errores, corregirlos y comprobar que el cambio sigue siendo compatible con el resto del sistema.
Por eso el verdadero salto de los agentes no es “generar más líneas por minuto”. Es reducir el número de pasos que una persona tiene que coordinar manualmente.
OpenAI describe GPT-5.5 como un modelo diseñado para comprender objetivos complejos, usar herramientas, comprobar su trabajo y llevar más tareas hasta su finalización. Anthropic, por su parte, ha estudiado cientos de miles de sesiones de Claude Code y ha encontrado un patrón interesante: en una sesión típica, la persona toma gran parte de las decisiones de planificación mientras el agente asume buena parte de la ejecución.
Esa separación es importante porque nos obliga a cambiar una idea antigua: programar con IA ya no consiste únicamente en conversar con un modelo. Consiste en diseñar un flujo de trabajo donde el modelo pueda observar, actuar y recibir evidencia de lo que ha ocurrido.
Copiloto frente a agente
Un copiloto tradicional suele trabajar alrededor del punto exacto donde está el desarrollador. Tú abres un archivo, escribes una función y pides una implementación. El sistema propone algo. Tú revisas, aceptas, corriges y continúas.
Un agente trabaja sobre una tarea más amplia. Puede recibir algo como:
“Añade recuperación de contraseña, respeta el flujo actual de autenticación, crea las validaciones necesarias y deja los tests pasando.”
La diferencia no está en que una frase sea más larga. La diferencia es que el segundo objetivo contiene una cadena de decisiones.
El agente tiene que localizar el sistema de autenticación. Tiene que descubrir cómo se almacenan los usuarios. Tiene que buscar rutas relacionadas. Tiene que identificar los componentes de interfaz. Tiene que comprobar cómo se envían correos o tokens. Tiene que decidir qué archivos modificar. Y, una vez hechos los cambios, tiene que comprobar si el proyecto compila y si los tests siguen pasando.
Eso es más parecido a gestionar una pequeña misión que a completar una línea de código.
Una forma sencilla de visualizarlo
| Copiloto | Agente |
|---|---|
| Completa código | Ejecuta una tarea completa |
| Suele trabajar en el archivo abierto | Explora el repositorio |
| Espera instrucciones frecuentes | Puede encadenar acciones |
| Propone una solución local | Puede modificar varias partes del sistema |
| La verificación suele recaer en la persona | Puede ejecutar tests y usar sus resultados |
| Gran valor por interacción | Gran valor por flujo completo |
Ninguna de las dos aproximaciones sustituye al criterio técnico. Lo que cambia es cuánto trabajo mecánico puede absorber la herramienta.
El terminal se convierte en una interfaz de alto nivel
Una de las razones por las que herramientas como Claude Code han despertado tanto interés es que el terminal deja de ser solo el lugar donde ejecutas comandos y se convierte en un punto de control para delegar trabajo sobre un repositorio.
Anthropic describe Claude Code como una herramienta de programación agéntica que vive en el terminal y en el propio repositorio. El flujo recomendado incluye leer el proyecto, planificar, actuar, observar el resultado y volver a ajustar. También existe la posibilidad de documentar las reglas del repositorio para que el agente comprenda cómo trabaja ese código base.
Esto es especialmente potente en proyectos modernos porque gran parte de su arquitectura está expresada en archivos que un agente puede inspeccionar: package.json, configuraciones de TypeScript, rutas, componentes, migraciones, tests, workflows de CI y documentación interna.
Pero hay una consecuencia menos obvia: cuanto más fácil sea para un agente actuar, más importante será que el repositorio explique bien sus propias reglas.
La documentación interna se vuelve infraestructura
Durante años se ha tratado la documentación como un complemento. En un mundo donde agentes leen el repositorio antes de modificarlo, algunas partes de esa documentación se convierten en una especie de API para el propio agente.
Un buen documento de proyecto debería responder preguntas como:
- ¿Cómo se ejecuta el proyecto localmente?
- ¿Qué comandos deben pasar antes de abrir un pull request?
- ¿Qué carpetas contienen la lógica sensible?
- ¿Qué librerías o patrones son obligatorios?
- ¿Qué decisiones arquitectónicas no deben cambiarse sin revisión?
- ¿Cómo se gestionan los secretos y las migraciones?
- ¿Qué rutas están protegidas?
- ¿Qué partes del producto siguen siendo experimentales?
Esto reduce una clase de errores muy particular: el código técnicamente correcto que contradice una decisión ya tomada por el equipo.
Un agente puede ser extraordinariamente bueno escribiendo una solución y, aun así, implementar el comportamiento equivocado si no entiende el contexto.
Planificar antes de tocar archivos
Uno de los hábitos más útiles al utilizar agentes es separar el modo de exploración del modo de ejecución.
Cuando una tarea es importante, lo razonable es pedir primero un plan. ¿Qué archivos se modificarían? ¿Qué dependencias hay? ¿Qué riesgos existen? ¿Qué tests deberían añadirse? ¿Qué preguntas siguen abiertas?
Después puede aprobarse ese plan y comenzar la ejecución.
Esta separación importa porque reduce un error frecuente de los sistemas agénticos: entrar demasiado rápido en modo edición. Un agente que empieza modificando archivos antes de entender el sistema puede crear una cadena de parches que arregla un síntoma y empeora la arquitectura.
La planificación también produce un beneficio humano. Obliga a convertir una petición difusa en un conjunto de decisiones explícitas.
La evidencia es el nuevo lenguaje de confianza
Un agente no debería ganarse nuestra confianza porque diga “he terminado”. Debería ganársela porque puede enseñar evidencia.
¿Compila el proyecto?
¿Pasan los tests?
¿Se comporta la ruta como se esperaba?
¿Han cambiado archivos que no estaban dentro del alcance?
¿La migración se puede aplicar en un entorno limpio?
¿El análisis estático detecta errores?
¿El build de producción sigue siendo correcto?
En una cultura de agentes, las salidas verificables adquieren más importancia que la seguridad verbal del modelo.
Anthropic encontró precisamente valor en medir sesiones donde el trabajo alcanzaba el objetivo con evidencia verificable, como tests que pasan o trabajo realmente comprometido.
La consecuencia es clara: un buen flujo agéntico no termina cuando el modelo responde. Termina cuando existe una comprobación independiente de que el resultado funciona.
El patrón de trabajo que mejor está envejeciendo
Un flujo práctico para un repositorio web puede ser:
1. Comprender
Leer la estructura, localizar los puntos relevantes y resumir el problema.
2. Planificar
Enumerar archivos, cambios, riesgos y pruebas necesarias.
3. Ejecutar
Modificar el mínimo número de piezas necesarias para conseguir el objetivo.
4. Verificar
Ejecutar lint, type-check, tests y build.
5. Inspeccionar
Revisar el diff. Comprobar que el agente no ha realizado cambios laterales.
6. Validar el producto
Abrir la aplicación y verificar el caso real, no solo el compilador.
7. Documentar
Dejar actualizado el conocimiento que necesitará el siguiente ciclo.
Este patrón puede parecer conservador, pero precisamente por eso escala bien.
Qué tareas funcionan especialmente bien
No todos los problemas son igual de adecuados para un agente.
Funcionan especialmente bien las tareas con un objetivo claro y una forma objetiva de validación. Refactorizar un módulo manteniendo tests, añadir una ruta con criterios definidos, actualizar un conjunto de componentes siguiendo un patrón existente, crear pruebas, corregir errores de tipos o investigar un fallo reproducible son buenos ejemplos.
También son interesantes las tareas repetitivas que tienen una estructura reconocible. Por ejemplo, si un proyecto tiene veinte páginas que siguen el mismo patrón de accesibilidad, una parte de ese trabajo puede delegarse de forma segura.
Lo que peor funciona son las tareas donde el éxito depende principalmente de contexto humano no expresado: decisiones de producto ambiguas, cambios que afectan a reputación de marca, migraciones irreversibles o trabajo donde el criterio correcto todavía no está definido.
El gran riesgo: un agente puede ser convincente y estar equivocado
La capacidad de actuar no elimina la posibilidad de error. La multiplica.
Un copiloto puede sugerir una función incorrecta. Tú decides rápidamente si aceptarla.
Un agente puede interpretar mal una premisa y convertir ese error inicial en veinte cambios coherentes entre sí.
La coherencia interna de una modificación no demuestra que la modificación sea correcta.
Por eso conviene utilizar límites. Un agente que puede editar archivos y ejecutar tests puede tener sentido. Uno que además puede modificar producción, tocar secretos, cambiar infraestructura y hacer despliegues sin una etapa explícita de revisión requiere un diseño de control mucho más cuidadoso.
Anthropic ha tratado precisamente este problema en el diseño de su modo automático de permisos. La empresa explica que la aprobación constante puede producir “approval fatigue” y que la alternativa no debería ser quitar todas las barreras, sino usar mecanismos como sandboxing y decisiones de permiso calibradas.
Por qué los permisos importan más que nunca
Un agente tiene capacidad. Los permisos determinan el radio de acción de esa capacidad.
Un patrón saludable consiste en separar:
Lectura: explorar código, documentación, logs y estructura.
Edición: modificar archivos dentro del proyecto.
Ejecución: ejecutar comandos locales con una superficie controlada.
Red: acceder a servicios externos solo cuando sea necesario.
Producción: cualquier acción contra infraestructura real.
Cuanto más abajo descendemos en esta lista, mayor debería ser la exigencia de confirmación y observabilidad.
No se trata de desconfiar de la IA por principio. Se trata de aplicar la misma idea que utilizaríamos con cualquier sistema automatizado que pudiera modificar infraestructura.
El desarrollador no desaparece: cambia de función
Esta es probablemente la idea más importante de todo el debate.
Cuando un agente ejecuta más trabajo, la habilidad valiosa no desaparece. Cambia de sitio.
Saber programar sigue siendo necesario porque alguien tiene que decidir si la arquitectura propuesta es correcta. Hay que entender límites, seguridad, deuda técnica, rendimiento, experiencia de usuario y comportamiento del producto.
La diferencia es que parte del tiempo que antes se dedicaba a producir cambios mecánicos puede dedicarse a revisar decisiones, diseñar sistemas y analizar resultados.
En el estudio de Anthropic, el conocimiento experto seguía correlacionándose con la capacidad del agente para realizar más trabajo por instrucción. Cuanto mayor era la experiencia del usuario, más trabajo tendía a ejecutar Claude por cada indicación.
Es una observación que merece atención: la automatización no elimina necesariamente la ventaja del experto. Puede amplificarla.
El repositorio del futuro deberá ser más legible para humanos y máquinas
Esto afecta incluso a cómo escribimos software.
Funciones pequeñas, nombres claros, tipos explícitos, pruebas fiables, configuraciones predecibles y documentación contextual son útiles para las personas. También lo son para los agentes.
Por el contrario, una arquitectura llena de excepciones implícitas, nombres ambiguos y efectos laterales difíciles de rastrear reduce la calidad del trabajo automatizado.
Dicho de otra forma: la buena ingeniería de software se convierte además en buena ingeniería para agentes.
Cómo utilizar agentes sin perder el control
Una estrategia razonable para un equipo pequeño puede empezar así:
Primero, tareas de bajo riesgo. Correcciones de UI, tests, documentación y refactors locales.
Después, tareas de flujo completo pero reversibles. Nuevas páginas, endpoints o componentes con validación automática.
Después, cambios de mayor impacto. Datos, autenticación, facturación o infraestructura, pero con revisión humana obligatoria.
Por último, automatización avanzada. Solo cuando el equipo tenga métricas y controles suficientes.
La velocidad debería crecer después de la confianza, no antes.
¿Qué cambia para una persona que programa sola?
Para un desarrollador independiente la oportunidad puede ser todavía mayor.
Un agente permite descargar parte del trabajo que normalmente exige cambiar constantemente de contexto. Buscar un archivo, comprender una ruta, crear un test, actualizar una configuración y revisar un error dejan de requerir tantas interrupciones manuales.
Eso no significa que la persona deje de programar. Significa que puede mantener una visión de producto con una capacidad de ejecución mucho mayor.
En un proyecto pequeño, la barrera histórica no siempre fue el conocimiento. A menudo fue el tiempo.
Los agentes atacan precisamente esa barrera.
¿Y para una empresa?
En una empresa aparecen otras preguntas: gobierno, propiedad intelectual, trazabilidad, permisos, auditoría y consistencia.
La ventaja de un agente no debería medirse solo en líneas de código generadas. Conviene medir cosas como:
- tiempo desde ticket hasta pull request;
- porcentaje de cambios que pasan las pruebas en el primer intento;
- tiempo medio de revisión;
- número de regresiones;
- tareas repetitivas eliminadas;
- tiempo recuperado para trabajo de mayor valor.
La métrica correcta no es “qué rápido escribe”. Es “qué parte del ciclo completo podemos automatizar sin aumentar el riesgo”.
Un futuro con agentes no es un futuro sin revisión
De hecho, probablemente será lo contrario.
Cuanto más capaces sean los sistemas, más importante resultará separar ejecución de autoridad.
Podremos tener agentes que preparen cambios, otros que revisen seguridad, otros que ejecuten tests, y una persona o un sistema de políticas que decida qué puede llegar a producción.
Ese modelo es más parecido a un equipo que a un chat.
El cambio conceptual es enorme. La pregunta deja de ser “¿qué código puede escribir la IA?” y pasa a ser “¿qué partes del proceso de ingeniería puedo convertir en un sistema verificable?”.
Lo que todavía no deberíamos delegar ciegamente
Hay áreas donde una revisión experta sigue siendo especialmente importante:
- decisiones de arquitectura con efectos a largo plazo;
- migraciones destructivas;
- gestión de secretos;
- autenticación y autorización;
- lógica financiera;
- cambios regulatorios;
- decisiones de producto ambiguas;
- despliegues irreversibles;
- cualquier cambio que pueda afectar a datos de clientes.
Un agente puede participar en todos esos ámbitos, incluso ser muy útil, pero participar no equivale a tener autoridad final.
Conclusión: la unidad de trabajo ya no es el archivo
La forma más sencilla de entender 2026 es esta: la unidad de trabajo de la IA de programación está desplazándose del archivo a la tarea.
Ya no le pedimos únicamente que escriba esta función o que arregle esta línea. Podemos empezar a pedirle que comprenda un objetivo, navegue por un sistema, ejecute una estrategia y entregue evidencia.
GPT-5.5 se presenta precisamente alrededor de esa idea de objetivos complejos, herramientas y tareas de principio a fin. Claude Code está explorando el mismo territorio desde el terminal y el repositorio.
Pero el futuro más interesante no será el del agente que puede hacer más cosas. Será el del agente integrado en un proceso que sabe cuándo actuar, qué puede tocar, cómo demostrar que lo hizo bien y cuándo debe detenerse para pedir una decisión humana.
La ventaja competitiva no estará simplemente en tener acceso a un modelo potente. Estará en tener un sistema de trabajo que convierta esa capacidad en resultados confiables.
Checklist para empezar mañana
Antes de utilizar un agente en un repositorio real, comprueba cinco cosas: que el proyecto pueda ejecutarse de forma reproducible, que exista una batería mínima de comprobaciones, que las reglas del repositorio estén documentadas, que los secretos estén fuera del alcance de la herramienta y que cada cambio importante deje evidencia revisable.
Después empieza con una tarea pequeña y reversible.
No necesitas esperar a la IA perfecta. Necesitas un proceso lo bastante bueno como para detectar cuándo la IA se equivoca.
Fuentes y recursos recomendados
- OpenAI — Introducing GPT-5.5
- OpenAI — GPT-5.6
- Anthropic — Agentic coding and persistent returns to expertise
- Anthropic — Claude Code: Foundations
- Anthropic — How we built Claude Code auto mode
Cuando el agente trabaja en un repositorio grande
El tamaño del repositorio cambia el problema. En un proyecto pequeño, una persona puede mantener el mapa mental completo del sistema. En uno grande, incluso un desarrollador experimentado necesita navegar constantemente entre módulos, servicios y configuraciones. Ahí el agente tiene una ventaja evidente: puede recorrer el árbol del proyecto mucho más rápido que una persona que intenta recordar dónde estaba cada pieza.
Pero la velocidad de exploración no equivale a comprensión perfecta. Un agente puede encontrar cincuenta archivos relevantes y seguir sin entender por qué una decisión arquitectónica se tomó hace dos años. Por eso, en repositorios grandes, la historia del proyecto importa casi tanto como su código.
Los commits, la documentación, los tests y los patrones repetidos se convierten en señales. Un agente que encuentra varias implementaciones coherentes tiene una pista mucho mejor que uno que recibe una descripción aislada.
Un buen repositorio enseña su intención
Hay una diferencia enorme entre un proyecto que dice “aquí hay una función” y uno que deja claro “esta función existe por esta razón y no debe utilizarse fuera de este contexto”.
Los comentarios más útiles para agentes no son los que repiten el código. Son los que explican decisiones, restricciones y excepciones.
También ayudan los tests que expresan comportamiento. Un test que comprueba que un usuario sin permisos recibe un error está comunicando una regla del sistema de manera mucho más fuerte que una frase en documentación.
El agente como compañero de investigación
No todo el valor tiene que ser ejecución. Los agentes también son buenos para investigar un problema técnico.
Puedes pedirles que sigan el recorrido de una petición desde una interfaz hasta una base de datos, comparen dos implementaciones, busquen dependencias relacionadas o localicen todas las rutas que utilizan una función concreta.
Ese tipo de trabajo reduce el coste de entrar en una parte desconocida del sistema.
La clave es separar investigación de modificación. Primero se descubre. Después se decide. Solo entonces se cambia.
El nuevo cuello de botella: revisar el resultado
Cuando la generación se vuelve más rápida, la revisión puede convertirse en el cuello de botella.
Esto parece paradójico: si una persona tarda treinta minutos en revisar un cambio que el agente produjo en cinco minutos, la automatización no ha reducido necesariamente el coste total.
Por eso aparecen nuevas oportunidades alrededor del propio proceso de revisión: tests automáticos mejores, análisis estático, previews, comprobaciones visuales y agentes especializados en code review.
La ingeniería del futuro no será únicamente generación. Será generación más verificación.
Una regla práctica para decidir qué delegar
Puedes puntuar una tarea con cuatro preguntas:
¿Es reversible?
¿Tiene una definición clara de terminado?
¿Existe una prueba automática o fácilmente observable?
¿El impacto de equivocarse es limitado?
Cuantas más respuestas sean afirmativas, mejor candidata es la tarea para un agente.
Una tarea que no cumple ninguna de ellas debería empezar con mucha más supervisión.
Agentes especializados frente a un agente gigante
Otro cambio interesante es la posibilidad de dividir trabajo.
Un agente puede encargarse de implementación, otro de pruebas, otro de documentación y otro de revisar seguridad o consistencia. No hace falta que todos tengan exactamente las mismas capacidades.
La ventaja de esta división es que cada fase puede tener un criterio de éxito distinto.
El agente de implementación busca completar el cambio.
El agente de pruebas busca descubrir fallos.
El agente de revisión busca cuestionar decisiones.
La persona responsable coordina y decide.
Esto recuerda más a un equipo de ingeniería que a una única herramienta mágica.
Qué debería cambiar en los equipos de desarrollo
Las reuniones no desaparecen porque exista IA. Pero algunas reuniones pueden cambiar de contenido.
En lugar de discutir durante una hora cómo implementar una tarea mecánica, un equipo puede dedicar el tiempo a decidir restricciones, interfaces, métricas y riesgos. Después, el agente ejecuta una parte del plan y devuelve evidencia.
La conversación técnica se desplaza ligeramente desde “cómo escribimos cada línea” hacia “qué queremos que sea cierto cuando terminemos”.
Ese cambio es profundo porque acerca la ingeniería de software al diseño de sistemas verificables.
La productividad real no es automática
Es tentador concluir que más capacidad de IA significa automáticamente más productividad. No siempre es así.
Un equipo puede producir más código y, al mismo tiempo, acumular más deuda técnica. Puede abrir más pull requests y aumentar el tiempo de revisión. Puede resolver más tickets y crear más regresiones.
Por eso conviene medir resultados de extremo a extremo.
El objetivo no es maximizar actividad. Es maximizar valor entregado de forma sostenible.
El criterio que probablemente sobrevivirá
Las herramientas cambiarán. Los modelos mejorarán. Los agentes tendrán más contexto y más capacidad de actuar.
Pero cuatro principios van a seguir siendo útiles: entender el objetivo antes de actuar, limitar permisos, verificar resultados y mantener autoridad humana sobre las decisiones irreversibles.
Esa combinación permite aprovechar la velocidad sin convertirla en riesgo.
Cierre ampliado
La mejor imagen de un agente de programación en 2026 no es la de un robot que sustituye al desarrollador sentado frente al teclado. Es la de una capa de ejecución que puede absorber una parte importante del trabajo mecánico y de coordinación mientras la persona conserva la visión del sistema.
Cuando un agente puede explorar, modificar, probar y corregir, el desarrollador deja de ser únicamente un productor de código y pasa a ser también director de un proceso automatizado.
Ese cambio requiere nuevas habilidades: escribir buenos objetivos, definir límites, diseñar comprobaciones, leer diffs con rapidez y reconocer qué decisiones no deben delegarse.
La paradoja es interesante: cuanto mejor se vuelve la IA para ejecutar, más importante se vuelve saber qué pedirle y cómo demostrar que lo hizo bien.
Cómo estructurar una tarea para un agente
Una petición vaga suele producir una solución vaga. Una petición bien delimitada funciona como una pequeña especificación.
En vez de decir “mejora el panel”, describe qué debe cambiar, qué debe mantenerse, qué rutas están afectadas y qué comprobaciones deben pasar. Esto reduce ambigüedad y permite que el agente compare su resultado con un objetivo observable.
Una buena tarea puede contener cinco piezas: contexto, objetivo, restricciones, criterios de aceptación y pruebas. El contexto explica dónde estamos. El objetivo explica qué queremos conseguir. Las restricciones dicen qué no debe tocarse. Los criterios de aceptación describen el resultado. Las pruebas convierten ese resultado en evidencia.
Un ejemplo realista
Contexto: aplicación Next.js con autenticación y Supabase.
Objetivo: añadir una pantalla de historial de sanciones para moderadores.
Restricciones: no abrir acceso al panel administrativo y mantener el sistema bilingüe.
Aceptación: un moderador puede consultar su historial, un miembro normal recibe una redirección, y lint/build deben pasar.
Verificación: comprobar ambas rutas y ejecutar las comprobaciones del proyecto.
El agente tiene ahora un espacio de decisión mucho más claro.
La memoria del proyecto importa
Otra diferencia entre un agente y una conversación aislada es que el agente puede volver repetidamente al mismo repositorio. Eso hace útil documentar decisiones que no deberían redescubrirse en cada tarea.
Qué significa un rol de moderador. Qué tabla representa una sanción. Qué endpoint es el oficial. Qué patrón de internacionalización utiliza la aplicación. Qué comandos se consideran obligatorios antes de entregar un cambio.
La memoria no tiene que ser sofisticada. Puede ser un conjunto de archivos claros y actualizados.
La revisión humana cambia de escala
Cuando el agente empieza a producir cambios más grandes, revisar línea por línea deja de ser una estrategia suficiente. La persona necesita revisar primero el mapa del cambio.
¿Cuántos archivos han cambiado? ¿Apareció una migración? ¿Se tocó autenticación? ¿Cambió una dependencia? ¿Se modificaron permisos? ¿Aparecieron nuevas rutas?
Después se profundiza en las partes sensibles.
Este enfoque permite revisar mucho más trabajo sin asumir que todo merece la misma atención.
Un pequeño sistema de métricas
Para saber si la automatización mejora el proceso, registra cuatro cosas: tiempo de implementación, tiempo de revisión, regresiones y porcentaje de tareas que necesitan rehacerse.
Si la implementación baja de una hora a diez minutos pero la revisión sube de veinte a cincuenta, el sistema no está necesariamente mejor.
Si el agente genera cambios más amplios pero las regresiones permanecen constantes, quizá el aumento de velocidad sí tenga sentido. Si las regresiones crecen, el proceso necesita más controles.
Medir evita confundir sensación de velocidad con productividad real.
Qué ocurrirá con el IDE
Los editores de código probablemente seguirán existiendo, pero la unidad de interacción puede cambiar. En lugar de pasar todo el día saltando de archivo en archivo, el desarrollador puede alternar entre visión arquitectónica, conversaciones con agentes y revisión de resultados.
Esto no elimina el teclado. Cambia la relación con él.
El editor se convierte en una ventana hacia un sistema donde diferentes tareas pueden progresar en paralelo.
El agente no es el producto
Es fácil caer en la fascinación por la herramienta. Pero para una empresa el activo real no es el agente concreto. Es el proceso que la empresa construye alrededor de él.
Un proveedor puede cambiar su modelo. Los precios pueden cambiar. Las interfaces pueden cambiar. Lo que debería permanecer es la disciplina: contexto, límites, herramientas, verificación y responsabilidad.
Eso permite sustituir una herramienta por otra sin reconstruir todo el sistema de ingeniería.
Un escenario cercano
Imagina abrir un ticket a primera hora. El agente analiza el repositorio, encuentra las rutas relevantes y prepara un plan. Mientras tú revisas arquitectura, otro proceso genera pruebas. Después el agente implementa y ejecuta las comprobaciones. Un segundo agente examina el diff en busca de regresiones. Tú recibes una propuesta con evidencia y decides si se integra.
Ese flujo todavía necesita supervisión. Pero la supervisión deja de consistir en escribir cada cambio manualmente.
La habilidad que gana valor: definir el sistema de evaluación
En un futuro de agentes, saber qué significa “hecho” será una habilidad técnica de primer nivel.
Un buen criterio de aceptación puede convertirse en una herramienta de productividad porque permite que la automatización se mueva sin esperar instrucciones cada pocos minutos.
Por eso los equipos deberían invertir tanto en tests, observabilidad y documentación como en modelos.
La próxima frontera
La evolución natural es pasar de agentes que trabajan sobre código a agentes que trabajan sobre el ciclo completo del producto: analizar incidencias, preparar cambios, probar, documentar, observar despliegues y aprender de resultados.
La dificultad no será únicamente conseguir modelos mejores. Será construir una arquitectura de herramientas donde cada capacidad tenga límites claros y donde el resultado sea auditable.
Ahí puede aparecer una forma de ingeniería híbrida: humanos definiendo objetivos y responsabilidad; agentes ejecutando y explorando; sistemas automáticos verificando; y producción permaneciendo protegida por políticas.
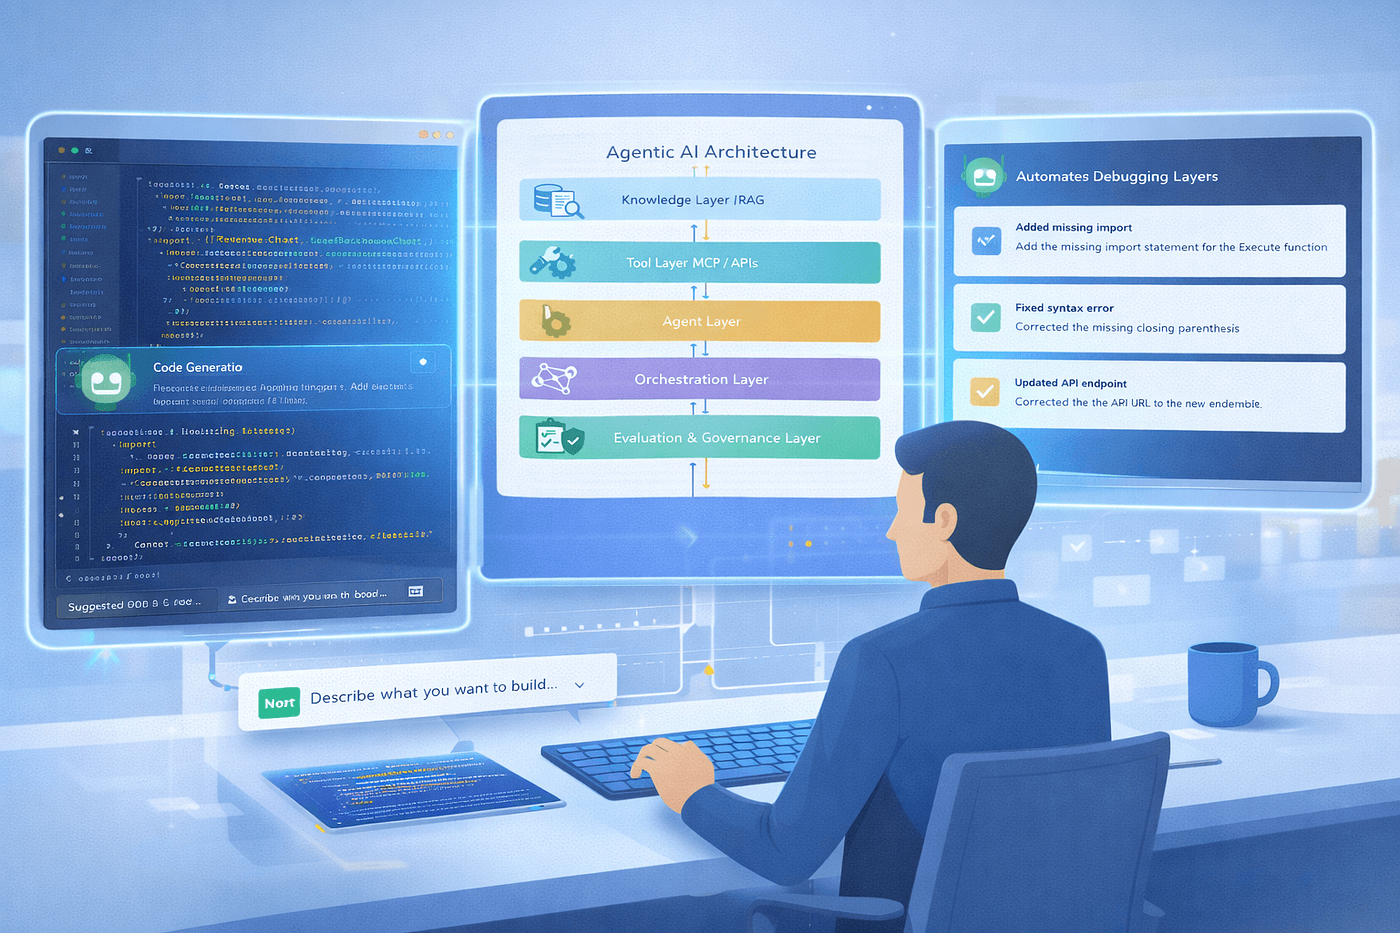
De copilotos a agentes: el cambio arquitectónico que realmente importa
La diferencia entre un copiloto y un agente no está únicamente en la interfaz. Está en el grado de autonomía y en la capacidad del sistema para observar contexto, elegir herramientas, ejecutar pasos y evaluar resultados. Ese cambio convierte una función de generación en un pequeño sistema operativo de trabajo.
Del texto a la acción
Un asistente tradicional responde. Un agente puede consultar una base, ejecutar una herramienta, comprobar el resultado y continuar. Cada paso nuevo añade poder, pero también una nueva superficie de fallo.
Herramientas con permisos mínimos
El diseño seguro comienza con herramientas estrechas. Un agente que puede “hacer cualquier cosa” es difícil de controlar. Es mejor proporcionar operaciones concretas, con argumentos validados y permisos limitados. La autorización debe estar en el servicio que ejecuta la acción, nunca únicamente en el prompt.
Bucles de verificación
La autonomía útil necesita comprobar sus propios resultados. Un agente que genera una consulta, ejecuta una operación y no valida la respuesta puede propagar errores. Los checkpoints, estados explícitos y límites de reintentos hacen el sistema más predecible.
Coste y observabilidad
Cada decisión puede implicar llamadas a modelos, herramientas y servicios externos. Por eso deben medirse latencia, coste, número de pasos, errores y tasa de intervención humana. Sin trazas, un fallo aparentemente “del modelo” puede estar realmente en una API externa o en una regla de negocio.
Dónde tiene sentido la autonomía
Los mejores casos iniciales son procesos con objetivo claro y posibilidad de recuperación: investigación interna, clasificación, preparación de borradores, triage o tareas administrativas acotadas. Los procesos irreversibles o de alto impacto necesitan más controles y, a menudo, aprobación humana.
El verdadero salto de 2026 no es que el software escriba más texto. Es que pueda completar partes de un proceso, siempre que la arquitectura controle permisos, estados, verificaciones y límites.
FMCP / MEDIA